/77
毎秒2000Reqを捌く
Perl製CMSの内部構造
nabe@abk
1
/77
Sec.1
はじめに
adiaryの紹介
2
/77
自己紹介
 名前:nabe
 ありきたりな名前にしたつもりが……
3
/77
自己紹介
 フリーランスエンジニア
 Perl
 JS, C, C#, C++, アセンブラ……
 Linux/FreeBSDサーバ管理
 DB設計、実装
 組み込み系プログラム
 回路設計、製作、アンプ、DAC……
 営業苦手
4
※お仕事募集してます
/77
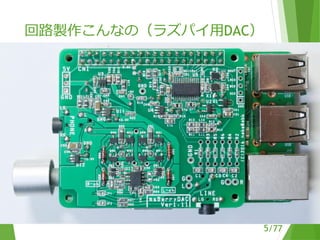
回路製作こんなの(ラズパイ用DAC)
5
/77
Perl製CMS「adiary」
 国産オープンソースCMS
 フルスクラッチ
 2006年から、ほぼ一人で開発
 HTML5準拠
 高機能
 超高速動作(ラズパイでも快適動作)
 pure Perlでも動作可能
 CGI, FastCGI, mod_perl全対応
6
/77
adiaryの特徴
 インストールが超簡単
 見た目の変更が簡単
 テーマシステム
 デザイン編集機能
 何もしなくてもスマホ対応
 快適な画像管理(ファイラー)
 Markdown / はてな記法の超拡張
 他多数
7
/77
adiaryの細かい特徴
 マルチユーザー
 マルチブログ
 サイト引っ越し支援(画像取込)
 WebPush
 Google AMP(自動変換)
 Facebook OGP / Twitter Cards
 コンテンツ管理(ツリー管理)
 階層式タグ機能
 プライベート機能
 強力な記事検索
 外部DB不要 / PostgreSQL , MySQL対応
 TeX数式標準対応
8
/77
Sec.2
adiaryのフレームワーク
Satsuki-systemの概要
9
/77
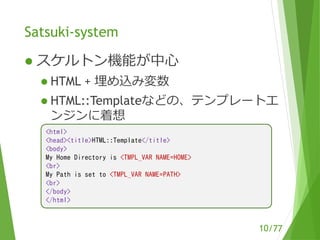
Satsuki-system
 スケルトン機能が中心
 HTML + 埋め込み変数
 HTML::Templateなどの、テンプレートエ
ンジンに着想
10
<html>
<head><title>HTML::Template</title>
<body>
My Home Directory is <TMPL_VAR NAME=HOME>
<br>
My Path is set to <TMPL_VAR NAME=PATH>
<br>
</body>
</html>
/77
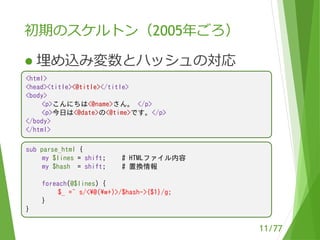
初期のスケルトン(2005年ごろ)
 埋め込み変数とハッシュの対応
11
<html>
<head><title><@title></title>
<body>
<p>こんにちは<@name>さん。 </p>
<p>今日は<@date>の<@time>です。</p>
</body>
</html>
sub parse_html {
my $lines = shift; # HTMLファイル内容
my $hash = shift; # 置換情報
foreach(@$lines) {
$_ =~ s/<@(w+)>/$hash->{$1}/g;
}
}
/77
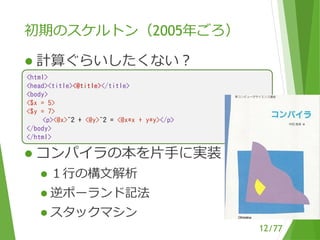
初期のスケルトン(2005年ごろ)
 計算ぐらいしたくない?
12
 コンパイラの本を片手に実装
 1行の構文解析
 逆ポーランド記法
 スタックマシン
<html>
<head><title><@title></title>
<body>
<$x = 5>
<$y = 7>
<p><@x>^2 + <@y>^2 = <@x*x + y*y></p>
</body>
</html>
/77
初期のスケルトン(2005年ごろ)
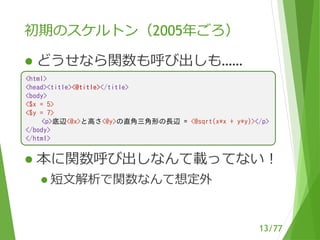
 どうせなら関数も呼び出しも……
13
 本に関数呼び出しなんて載ってない!
 短文解析で関数なんて想定外
<html>
<head><title><@title></title>
<body>
<$x = 5>
<$y = 7>
<p>底辺<@x>と高さ<@y>の直角三角形の長辺 = <@sqrt(x*x + y*y)></p>
</body>
</html>
/77
初期のスケルトン(2005年ごろ)
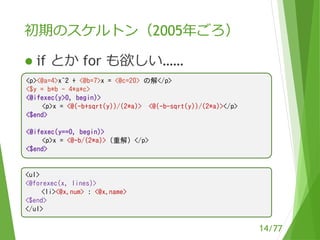
 if とか for も欲しい……
14
<p><@a=4>x^2 + <@b=7>x = <@c=20> の解</p>
<$y = b*b - 4*a*c>
<@ifexec(y>0, begin)>
<p>x = <@(-b+sqrt(y))/(2*a)>, <@(-b-sqrt(y))/(2*a)></p>
<$end>
<@ifexec(y==0, begin)>
<p>x = <@-b/(2*a)>(重解)</p>
<$end>
<ul>
<@forexec(x, lines)>
<li><@x.num> : <@x.name>
<$end>
</ul>
/77
初期のスケルトン(2005年ごろ)
15
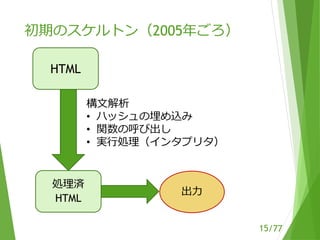
HTML
処理済
HTML
構文解析
• ハッシュの埋め込み
• 関数の呼び出し
• 実行処理(インタプリタ)
出力
/77
初期のスケルトン(2005年ごろ)
16
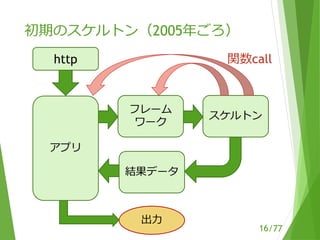
http
アプリ
スケルトン
フレーム
ワーク
結果データ
出力
関数call
/77
スケルトンにできること
 式の記述(計算)
 関数の呼び出し
 制御構文
17
進化しすぎて
プログラムが書けてしまう
/77
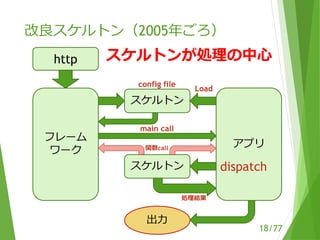
改良スケルトン(2005年ごろ)
18
http
フレーム
ワーク
アプリ
スケルトン
出力
Load
main call
スケルトン
処理結果
dispatch
関数call
スケルトンが処理の中心
config file
/77
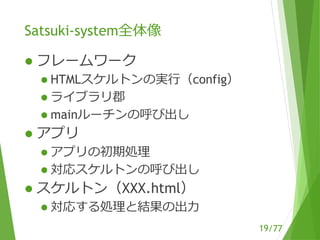
Satsuki-system全体像
 フレームワーク
 HTMLスケルトンの実行(config)
 ライブラリ郡
 mainルーチンの呼び出し
 アプリ
 アプリの初期処理
 対応スケルトンの呼び出し
 スケルトン(XXX.html)
 対応する処理と結果の出力
19
/77
スケルトンシステムのパラダイム
 アプリが対応するスケルトンを選択
 対応するスケルトンが処理の中心
 アプリもフレームワークも
スケルトンのための部品にすぎない
20
/77
adiaryの真相
 2005年 スケルトンシステム製作
 2006年
 スケルトンシステムがよく出来ていた
 何か作って良さをアピールしたい
 ブログが流行っていた
21
2006年末
adiary 1.00リリース
そうだ、
ブログシステムを
作ろう!
/77
なぜPerlだったのか
 2006年 Movable Typeが主流
 クソ重たかった
 開発前にベンチマークを取った
 Perl 5.6
 Ruby 1.8.x
 PHP5
 圧倒的にPerlが速かった
 その後も、Perlはバージョンアップする
ごとに速くなっている
22
/77
Sec.3
スケルトンの高速化
インタプリタからコンパイラへ
23
/77
初期のスケルトンの問題点
 構文解析が遅い
 正規表現の塊
 開発が進み高機能になるほど遅くなる
24
解析結果をキャッシュしよう
/77
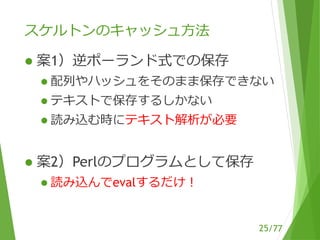
スケルトンのキャッシュ方法
 案1)逆ポーランド式での保存
 配列やハッシュをそのまま保存できない
 テキストで保存するしかない
 読み込む時にテキスト解析が必要
 案2)Perlのプログラムとして保存
 読み込んでevalするだけ!
25
/77
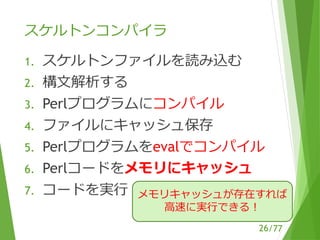
スケルトンコンパイラ
1. スケルトンファイルを読み込む
2. 構文解析する
3. Perlプログラムにコンパイル
4. ファイルにキャッシュ保存
5. Perlプログラムをevalでコンパイル
6. Perlコードをメモリにキャッシュ
7. コードを実行
26
メモリキャッシュが存在すれば
高速に実行できる!
/77
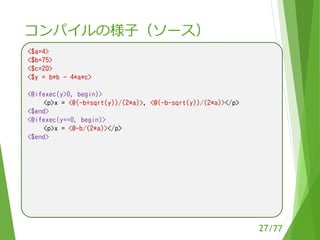
コンパイルの様子(ソース)
27
<$a=4>
<$b=75>
<$c=20>
<$y = b*b - 4*a*c>
<@ifexec(y>0, begin)>
<p>x = <@(-b+sqrt(y))/(2*a)>, <@(-b-sqrt(y))/(2*a)></p>
<$end>
<@ifexec(y==0, begin)>
<p>x = <@-b/(2*a)></p>
<$end>
/77
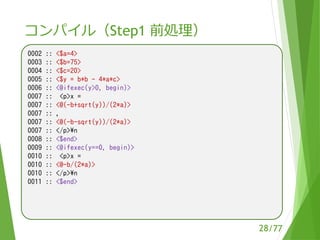
コンパイル(Step1 前処理)
28
0002 :: <$a=4>
0003 :: <$b=75>
0004 :: <$c=20>
0005 :: <$y = b*b - 4*a*c>
0006 :: <@ifexec(y>0, begin)>
0007 :: <p>x =
0007 :: <@(-b+sqrt(y))/(2*a)>
0007 :: ,
0007 :: <@(-b-sqrt(y))/(2*a)>
0007 :: </p>n
0008 :: <$end>
0009 :: <@ifexec(y==0, begin)>
0010 :: <p>x =
0010 :: <@-b/(2*a)>
0010 :: </p>n
0011 :: <$end>
/77
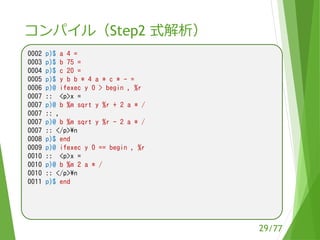
コンパイル(Step2 式解析)
29
0002 p)$ a 4 =
0003 p)$ b 75 =
0004 p)$ c 20 =
0005 p)$ y b b * 4 a * c * - =
0006 p)@ ifexec y 0 > begin , %r
0007 :: <p>x =
0007 p)@ b %m sqrt y %r + 2 a * /
0007 :: ,
0007 p)@ b %m sqrt y %r - 2 a * /
0007 :: </p>n
0008 p)$ end
0009 p)@ ifexec y 0 == begin , %r
0010 :: <p>x =
0010 p)@ b %m 2 a * /
0010 :: </p>n
0011 p)$ end
/77
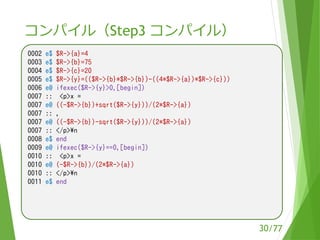
コンパイル(Step3 コンパイル)
30
0002 e$ $R->{a}=4
0003 e$ $R->{b}=75
0004 e$ $R->{c}=20
0005 e$ $R->{y}=(($R->{b}*$R->{b})-((4*$R->{a})*$R->{c}))
0006 e@ ifexec($R->{y}>0,[begin])
0007 :: <p>x =
0007 e@ ((-$R->{b})+sqrt($R->{y}))/(2*$R->{a})
0007 :: ,
0007 e@ ((-$R->{b})-sqrt($R->{y}))/(2*$R->{a})
0007 :: </p>n
0008 e$ end
0009 e@ ifexec($R->{y}==0,[begin])
0010 :: <p>x =
0010 e@ (-$R->{b})/(2*$R->{a})
0010 :: </p>n
0011 e$ end
/77
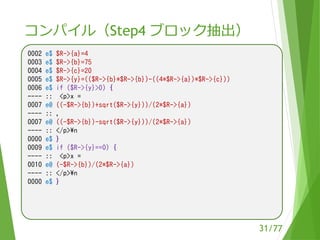
コンパイル(Step4 ブロック抽出)
31
0002 e$ $R->{a}=4
0003 e$ $R->{b}=75
0004 e$ $R->{c}=20
0005 e$ $R->{y}=(($R->{b}*$R->{b})-((4*$R->{a})*$R->{c}))
0006 e$ if ($R->{y}>0) {
---- :: <p>x =
0007 e@ ((-$R->{b})+sqrt($R->{y}))/(2*$R->{a})
---- :: ,
0007 e@ ((-$R->{b})-sqrt($R->{y}))/(2*$R->{a})
---- :: </p>n
0000 e$ }
0009 e$ if ($R->{y}==0) {
---- :: <p>x =
0010 e@ (-$R->{b})/(2*$R->{a})
---- :: </p>n
0000 e$ }
/77
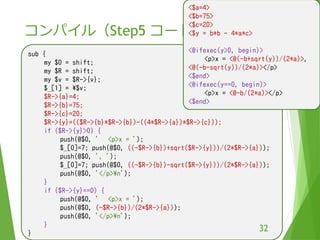
sub {
my $O = shift;
my $R = shift;
my $v = $R->{v};
$_[1] = $v;
$R->{a}=4;
$R->{b}=75;
$R->{c}=20;
$R->{y}=(($R->{b}*$R->{b})-((4*$R->{a})*$R->{c}));
if ($R->{y}>0) {
push(@$O, ' <p>x = ');
$_[0]=7; push(@$O, ((-$R->{b})+sqrt($R->{y}))/(2*$R->{a}));
push(@$O, ', ');
$_[0]=7; push(@$O, ((-$R->{b})-sqrt($R->{y}))/(2*$R->{a}));
push(@$O, '</p>n');
}
if ($R->{y}==0) {
push(@$O, ' <p>x = ');
push(@$O, (-$R->{b})/(2*$R->{a}));
push(@$O, '</p>n');
}
}
コンパイル(Step5 コード化)
32
<$a=4>
<$b=75>
<$c=20>
<$y = b*b - 4*a*c>
<@ifexec(y>0, begin)>
<p>x = <@(-b+sqrt(y))/(2*a)>,
<@(-b-sqrt(y))/(2*a)></p>
<$end>
<@ifexec(y==0, begin)>
<p>x = <@-b/(2*a)></p>
<$end>
/77
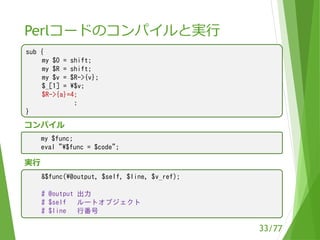
sub {
my $O = shift;
my $R = shift;
my $v = $R->{v};
$_[1] = $v;
$R->{a}=4;
:
}
Perlコードのコンパイルと実行
33
my $func;
eval "$func = $code";
コンパイル
&$func(@output, $self, $line, $v_ref);
# @output 出力
# $self ルートオブジェクト
# $line 行番号
実行
/77
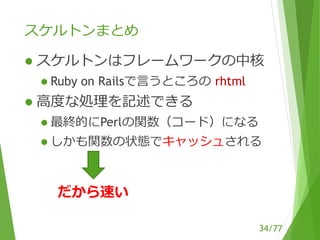
スケルトンまとめ
 スケルトンはフレームワークの中核
 Ruby on Railsで言うところの rhtml
 高度な処理を記述できる
 最終的にPerlの関数(コード)になる
 しかも関数の状態でキャッシュされる
34
だから速い
/77
Sec.4
ファイルのロードを速くする
徹底的にキャッシュする
35
/77
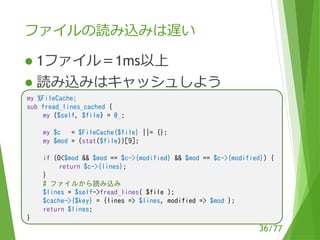
ファイルの読み込みは遅い
 1ファイル=1ms以上
 読み込みはキャッシュしよう
36
my %FileCache;
sub fread_lines_cached {
my ($self, $file) = @_;
my $c = $FileCache{$file} ||= {};
my $mod = (stat($file))[9];
if (0<$mod && $mod == $c->{modified} && $mod == $c->{modified}) {
return $c->{lines};
}
# ファイルから読み込み
$lines = $self->fread_lines( $file );
$cache->{$key} = {lines => $lines, modified => $mod };
return $lines;
}
/77
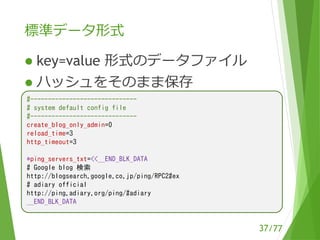
標準データ形式
 key=value 形式のデータファイル
 ハッシュをそのまま保存
37
#------------------------------
# system default config file
#------------------------------
create_blog_only_admin=0
reload_time=3
http_timeout=3
*ping_servers_txt=<<__END_BLK_DATA
# Google blog 検索
http://blogsearch.google.co.jp/ping/RPC2#ex
# adiary official
http://ping.adiary.org/ping/#adiary
__END_BLK_DATA
/77
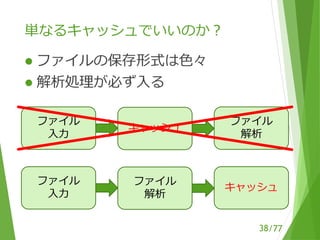
単なるキャッシュでいいのか?
 ファイルの保存形式は色々
 解析処理が必ず入る
38
ファイル
入力
キャッシュ
ファイル
解析
ファイル
入力
ファイル
解析
キャッシュ
/77
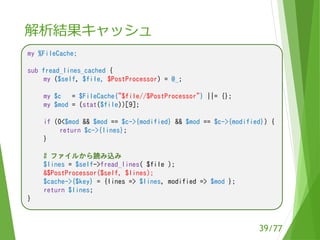
解析結果キャッシュ
39
my %FileCache;
sub fread_lines_cached {
my ($self, $file, $PostProcessor) = @_;
my $c = $FileCache{"$file//$PostProcessor"} ||= {};
my $mod = (stat($file))[9];
if (0<$mod && $mod == $c->{modified} && $mod == $c->{modified}) {
return $c->{lines};
}
# ファイルから読み込み
$lines = $self->fread_lines( $file );
&$PostProcessor($self, $lines);
$cache->{$key} = {lines => $lines, modified => $mod };
return $lines;
}
/77
解析結果キャッシュ付ファイル入力
 fread_lines_cached() 関数
 ファイル名と解析ルーチンを渡す
 キャッシュ処理はおまかせ
 ファイルの更新日時チェックだけ
 更新日時チェックも実はちょっと遅い
 基本的にシステムコールは遅い
40
/77
もっと高負荷なファイル処理がある
 ファイル入力より重いファイルロード
41
Perl モジュール(.pm)が
一番重い
※DynaLoaderなんて最悪に重い……
/77
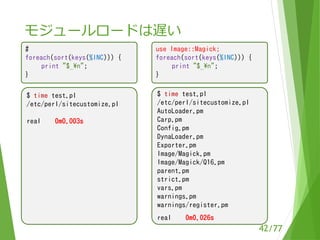
モジュールロードは遅い
42
#
foreach(sort(keys(%INC))) {
print "$_n";
}
use Image::Magick;
foreach(sort(keys(%INC))) {
print "$_n";
}
$ time test.pl
/etc/perl/sitecustomize.pl
real 0m0.003s
$ time test.pl
/etc/perl/sitecustomize.pl
AutoLoader.pm
Carp.pm
Config.pm
DynaLoader.pm
Exporter.pm
Image/Magick.pm
Image/Magick/Q16.pm
parent.pm
strict.pm
vars.pm
warnings.pm
warnings/register.pm
real 0m0.026s
/77
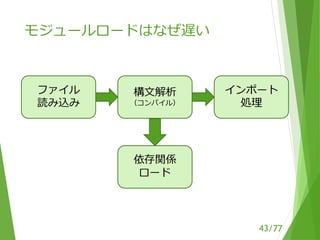
モジュールロードはなぜ遅い
43
ファイル
読み込み
構文解析
(コンパイル)
インポート
処理
依存関係
ロード
/77
気にしないという手も……
 SpeedyCGI, FastCGI, mod_perl2
 Perlキャッシュ環境では関係ない
 Satsuki-systemはすべてに対応!
 CGI動作は捨てても良い?
 個人レベルではCGIもまだまだ現役
 adiary利用者の8割はCGI動作
44
CGIでも速く動かしたい!
/77
CGIでも速く動かすために
45
 モジュールは必要な時にロードする
 use ではなく require
 インポート処理をさせない
 use Encode; from_to(); ではなく
 require Encode; Encode::from_to(); で
 重いモジュールは使わない
 車輪の再発明も辞さない
 AutoLoader.pm によるモジュール分割
/77
Satsuki::AutoLoader
46
 メインモジュールは3分割されている
 Base.pm GET関連の処理
 Base_2.pm POST関連の処理
 Base_3.pm FastCGI/mod_perl2関連
 最初は Base.pm
 関数が見つからない時
 Base_2.pm, Base_3.pmと順にロード
 最後まで見つからなければエラー
/77
FastCGI, mod_perl2にも問題あり
47
 モジュールをキャッシする
 ロードが発生しないので高速
 当然リロードもしない
 アップデート時や開発時に困る
 ライブラリ更新チェック機能を内蔵
 更新時は自動でリロード
 システムの再起動は不要
/77
ライブラリunload(自作コード)
48
sub unload {
no strict 'refs';
my $pkg = shift;
$pkg =~ s/.pm$//;
$pkg =~ s[/][::]g;
my $names = %{ $pkg . '::' };
# パッケージの名前空間からすべて除去
foreach(keys(%$names)) {
substr($_,-2) eq '::' && next;
undef $names->{$_}; # 全型の変数開放
}
}
ただの魔法(笑)
/77
ファイルロードのまとめ
 ファイルの入力はキャッシュする
 モジュールのロードは遅い
 必要になったらロードする
 あらかじめ分割しておく
49
/77
Sec.5
データベースは必要ですか?
テキストファイルで作るデータベース
50
/77
RDBMSは遅い
Relational DataBase Management System
 高度な関係性(Relation)を記述
 高信頼性やスケール化は求めてない
 欠点
 高度でリッチすぎる
 SQL文の字句解析が入る
 DBモジュールのロードが超遅い
 30~50ms
 使うなら FastCGI や mod_perl2 とかで……
51
/77
DBモジュール
 DBのAPIを統一しモジュール化
 Satsuki::DB_mysql
 Satsuki::DB_pg
 Satsuki::DB_text
 入れ替え可能
 CMSにSQLなんて必要ない
52
/77
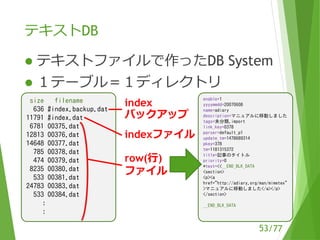
テキストDB
 テキストファイルで作ったDB System
 1テーブル=1ディレクトリ
53
size filename
636 #index.backup.dat
11791 #index.dat
6781 00375.dat
12813 00376.dat
14648 00377.dat
785 00378.dat
474 00379.dat
8235 00380.dat
533 00381.dat
24783 00383.dat
533 00384.dat
:
:
indexファイル
index
バックアップ
row(行)
ファイル
enable=1
yyyymmdd=20070608
name=adiary
description=マニュアルに移動しました
tags=未分類,import
link_key=0378
parser=default_p1
update_tm=1478689314
pkey=378
tm=1181315372
title=記事のタイトル
priority=0
*text=<<__END_BLK_DATA
<section>
<p><a
href="http://adiary.org/man/mimetex"
>マニュアルに移動しました</a></p>
</section>
__END_BLK_DATA
/77
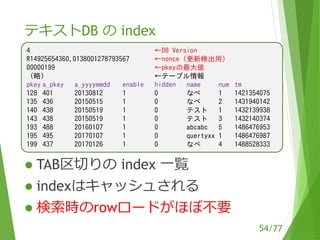
テキストDB の index
54
4 ←DB Version
R14925654360.0138001278793567 ←nonce(更新検出用)
00000199 ←pkeyの最大値
(略) ←テーブル情報
pkey a_pkey a_yyyymmdd enable hidden name num tm
128 401 20130812 1 0 なべ 1 1421354075
135 436 20150515 1 0 なべ 2 1431940142
140 438 20150519 1 0 テスト 1 1432139938
143 438 20150519 1 0 テスト 3 1432140374
193 488 20160107 1 0 abcabc 5 1486476953
195 495 20170107 1 0 quertyxx 1 1486476987
199 437 20170126 1 0 なべ 4 1488528333
 TAB区切りの index 一覧
 indexはキャッシュされる
 検索時のrowロードがほぼ不要
/77
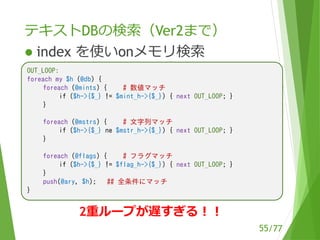
テキストDBの検索(Ver2まで)
55
 index を使いonメモリ検索
OUT_LOOP:
foreach my $h (@db) {
foreach (@mints) { # 数値マッチ
if ($h->{$_} != $mint_h->{$_}) { next OUT_LOOP; }
}
foreach (@mstrs) { # 文字列マッチ
if ($h->{$_} ne $mstr_h->{$_}) { next OUT_LOOP; }
}
foreach (@flags) { # フラグマッチ
if ($h->{$_} != $flag_h->{$_}) { next OUT_LOOP; }
}
push(@ary, $h); ## 全条件にマッチ
}
2重ループが遅すぎる!!
/77
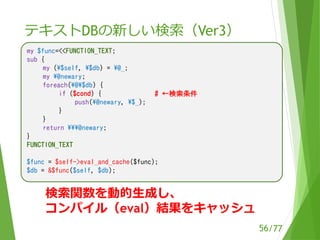
テキストDBの新しい検索(Ver3)
56
my $func=<<FUNCTION_TEXT;
sub {
my ($self, $db) = @_;
my @newary;
foreach(@$db) {
if ($cond) { # ←検索条件
push(@newary, $_);
}
}
return @newary;
}
FUNCTION_TEXT
$func = $self->eval_and_cache($func);
$db = &$func($self, $db);
検索関数を動的生成し、
コンパイル(eval)結果をキャッシュ
/77
テキストDBの更新処理
 index = 1ファイル
 検索(読み込み)が速い
 更新(書き換え)が遅い
 indexファイルを lock してすべて再生成
 更新ごとに、必ずHDDに同期させる
 アクセス数に対する更新の発生率
 多くて1%程度
 数千件ぐらいまでは問題ない
57
/77
 更新が大量に発生すると問題になる
 記事のインポート
 記事の再構築
 なぜ問題になる?
 1記事ごとにHDDに同期させるから遅い
テキストDBの更新問題
58
メモリ中で書き換えを行い
最後に結果を反映させれば良いのでは?
つまり
トランザクション
/77
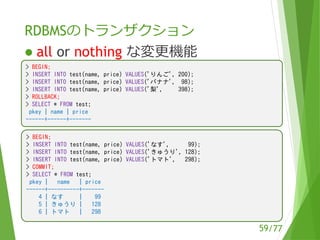
RDBMSのトランザクション
59
 all or nothing な変更機能
> BEGIN;
> INSERT INTO test(name, price) VALUES('りんご', 200);
> INSERT INTO test(name, price) VALUES('バナナ', 98);
> INSERT INTO test(name, price) VALUES('梨', 398);
> ROLLBACK;
> SELECT * FROM test;
pkey | name | price
------+------+-------
> BEGIN;
> INSERT INTO test(name, price) VALUES('なす', 99);
> INSERT INTO test(name, price) VALUES('きゅうり', 128);
> INSERT INTO test(name, price) VALUES('トマト', 298);
> COMMIT;
> SELECT * FROM test;
pkey | name | price
------+----------+-------
4 | なす | 99
5 | きゅうり | 128
6 | トマト | 298
/77
テキストDBのトランザクション
60
 更新ファイルをすべて lock
 更新データをすべてメモリに展開
 commit() 時に一気に書き換える
 失敗時は全データ破棄
100倍の高速化(記事が多いとき)
/77
テキストDBまとめ
61
 テキストファイルでもDBになる
 数百件ならRDBMSより速い
 検索の2重ループは遅い
 検索関数を動的生成して高速化
 大量の更新処理が遅い
 トランザクションを実装して高速化
/77
Sec.6
その他の高速化
小さなことでもコツコツと
62
/77
高速化の原則
 更新(POST)は表示(GET)の1%以下
 表示に必要なデータは更新時に生成し
キャッシュする
 最近の記事一覧
 最近のコメント一覧
 タグ一覧
 月別の過去ログ
 ほか
63
/77
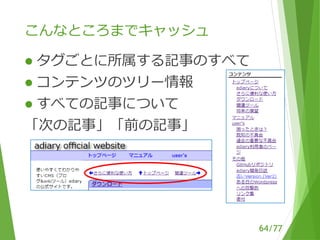
こんなところまでキャッシュ
 タグごとに所属する記事のすべて
 コンテンツのツリー情報
 すべての記事について
「次の記事」「前の記事」
64
/77
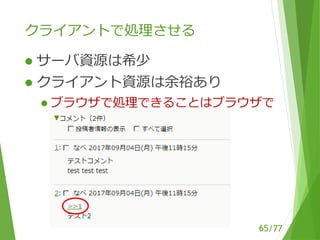
クライアントで処理させる
 サーバ資源は希少
 クライアント資源は余裕あり
 ブラウザで処理できることはブラウザで
65
/77
ファイル数を少なくする
 処理に必要なファイル数を減らす
 いくらキャッシュが効いても……
 タイムスタンプ確認も速くはない
 ブログ設定は1ファイルに集約
 中身はハッシュ(標準データ形式)
 Windowsのレジストリみたいなもの
66
/77
Sec.7
計測
そして禁断の果実へ……
67
/77
ベンチマーク方法
 Debian jessie
 Core i3-530(2010年製/第1世代)
 RAM 4GB
 Apache 2.4 + mod_perl2
 nginx + FastCGIでも似た結果
68
/77
テスト方法
 adiary公式サイトのコピーを作成
 テキストDB使用
 トップページを表示テスト
 ApacheBenchをローカルで発行
 ab -n 1000 -c 100 –l
 1000アクセス、同時100アクセス
 アクセス先は ethernet を設定
69
/77
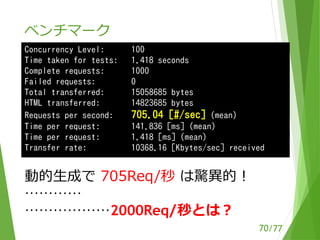
ベンチマーク
70
Concurrency Level: 100
Time taken for tests: 1.418 seconds
Complete requests: 1000
Failed requests: 0
Total transferred: 15058685 bytes
HTML transferred: 14823685 bytes
Requests per second: 705.04 [#/sec] (mean)
Time per request: 141.836 [ms] (mean)
Time per request: 1.418 [ms] (mean)
Transfer rate: 10368.16 [Kbytes/sec] received
動的生成で 705Req/秒 は驚異的!
……
………………2000Req/秒とは?
……
/77
禁断の果実 ページキャッシュ
 ページの表示アクセスをキャッシュ
 「W○rdpress 1000倍高速化」では……
 キャッシュ用プラグイン
 または nginxの fastcgi_cache を使う
 fastcgi_cache は 10分~1時間程度、何が
あってもキャッシュを返す。
 たとえページが消えていても!
 表示ごとに変化させたり動作させたり
出来なくなる
71
/77
ページキャッシュ内蔵してます
 管理画面から設定をonにするだけ
 表示処理で問題ない時のみ動作
 ログイン時は動作しない
 キャッシュ数、時間に上限設定あり
 更新時はキャッシュを破棄
72
/77
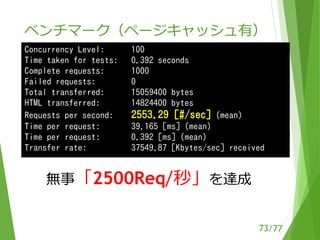
ベンチマーク(ページキャッシュ有)
73
Concurrency Level: 100
Time taken for tests: 0.392 seconds
Complete requests: 1000
Failed requests: 0
Total transferred: 15059400 bytes
HTML transferred: 14824400 bytes
Requests per second: 2553.29 [#/sec] (mean)
Time per request: 39.165 [ms] (mean)
Time per request: 0.392 [ms] (mean)
Transfer rate: 37549.87 [Kbytes/sec] received
無事「2500Req/秒」を達成
/77
Sec.8
まとめ
74
/77
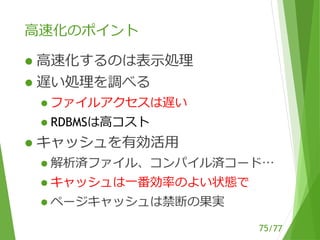
高速化のポイント
 高速化するのは表示処理
 遅い処理を調べる
 ファイルアクセスは遅い
 RDBMSは高コスト
 キャッシュを有効活用
 解析済ファイル、コンパイル済コード…
 キャッシュは一番効率のよい状態で
 ページキャッシュは禁断の果実
75
/77
ひとことで言うと
Perlは速い
76
/7777
おわり